


 N0r10
こんにちは、システム・エムズの N0r10 です。
その1では、Claude Codeにカメラの目をつけました。今回は耳と口です。ついでに顔もつけました。
これで、Claudeに声で話しかけると、ふつうは4〜5秒で声の返事が来るようになりました。「クロード」のような呼びかけはいりません。返事の途中で話しかければ、ちゃんと黙ります。目と耳と口と顔がそろったので、アプリの名前もClaudeEyesからClaudeFaceに改めました。
耳をつける
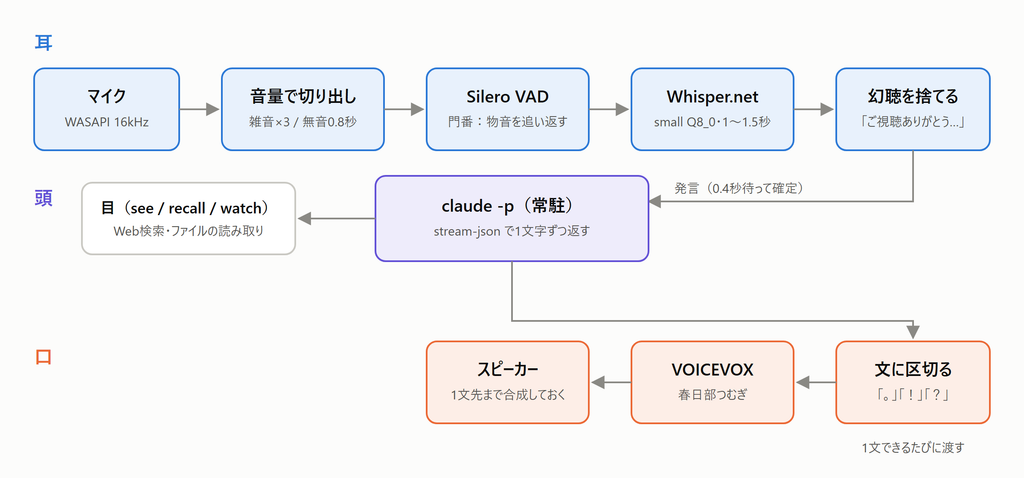
アプリは、目のときと同じC#の1プロセスです。中にMCPサーバーを持っていて、そこに上の図の耳の流れを足しました。
全部ローカルのCPUで動きます。PCはi9-13900Hで、GPUはありません。
音量で聞き耳を立てる
マイクはWASAPIの共有モードで開き、16kHzモノラルで受け取ります。30msごとに音量(RMS)を計算し、直近1.5秒の雑音レベルの3倍を超えたら「何か聞こえた」とみなします。最初の音を切らないよう、0.3秒前までさかのぼって含める作りです。0.8秒静かになれば、そこが区切りです。
ただ、音量だけだとキーボードも椅子のきしみも拾います。なので、Whisperに渡す前に、Whisper.netに入っているSilero VADで「人の声が0.3秒以上あるか」を確かめます。1件10〜20msで終わる門番です。
試しに10分間、ふだんどおり仕事をしながら聞かせてみました。音量で拾ったのは71件。そのうち51件を門番が物音として追い返し、Whisperまで届いたのは11件でした。中身はほぼ私の独り言です。仕事中の自分がこんなにしゃべっているとは知りませんでした。
Whisperを速くする
文字起こしはWhisper.net(whisper.cpp)のsmallを、Q8_0に量子化したモデルで動かしています。既定のままだと、2〜5秒の発話に2.3〜4.7秒かかりました。会話でこれは待てません。次の設定で1.0〜1.5秒まで縮みました。
- audio contextを768にする。whisper.cppは短い発話でも30秒分の枠で処理するので、枠を15秒分に縮める(だから発話も15秒で区切る)。512まで縮めるともっと速いが、「クロード」が「クロート」になった
- スレッド数は論理コアの7割(このPCで14)
- ビームサーチをやめて貪欲法にする。遅くなるだけで精度は上がらなかった
- 前の発話を文脈として引き継がない。捨てた幻聴や周りの人の声に引きずられないように
- 温度を上げたやり直しをしない。雑音で処理が何倍にも延びるのを防ぐ
- 1セグメント64トークンまで。「んんんん…」が数百文字続く幻聴を止める
固有名詞は聞き違えやすいので、ClaudeやVOICEVOXなどの短い単語リストもプロンプトで渡しています。
Whisperの中の人はYouTuber
門番を通っても、Whisperは静かなところで急に「ご視聴ありがとうございました」や「ご覧いただきありがとうございます」と言い出します。動画の締めの言葉を大量に学習しているせいだと思います。こうした決まり文句、全体がカッコに入ったもの(「(拍手)」など)、同じ文字の繰り返し、「えーと」だけの発話は、捨てることにしました。
困ったのが「高評価」です。丸ごと捨てると、ふつうに評価の話をしたときまで聞こえなくなります。「高評価お願いします」のような締めの言い回しのときだけ捨てるようにしました。
話し終わりを待つ
0.8秒の無音で区切ったあと、さらに0.4秒待って、1つの発言として確定します。最後が「けど」「から」のように続きそうな語なら、待ち時間は1.5秒です。人が相づちのタイミングを計るのと同じことを、数字で決めています。
呼びかけの言葉がないので、独り言も同僚との会話も全部Claudeに届きます。自分宛てでないと思ったら「…」とだけ返すよう頼んであり、そのときは黙っています。聞き流すのも擬人化のうちです。
会議は盗み聞きしない
Windowsの共有モードでは、1つのマイクを複数のアプリで同時に録れます。放っておくと、Teamsの会議の発言まで全部Claudeに筒抜けです。そこで、他のアプリがマイクを使っている間は耳をふさぎます。どのアプリがマイクを使っているかは、レジストリの記録で分かります。
ここで1つハマりました。Claudeのデスクトップアプリから起動すると、アプリから見えるAppDataの場所が変わります。そのせいで、マイクを使っているのが自分だと気づけず、自分の録音を「誰かが会議している」と勘違いして、自分で耳をふさいでいました。今はexe名で判定しています。
口をつける
きっかけはClaudeのテスト用の声
最初は、しゃべらせるつもりはありませんでした。耳だけつけて、返事はチャットに書いてもらえば十分だと思っていたからです。
ところが耳を作っている途中で、Claudeがテスト用の音声をWindows標準の音声合成で作っていました。自分の耳を試すために、自分で話しかける声を作っていたわけです。それを見て、しゃべれるならしゃべらせようと決めました。
ただ、Windows標準の日本語音声は「回鍋肉風」を「かいなべにくかぜ」と読みます。これでは食事の相談もできないので、VOICEVOXにしました。こちらはちゃんと「ホイコーロー風」と読みます。声は春日部つむぎにしました。ずんだもんも試しましたが、語尾が「なのだ」寄りなので、ふだんの相手には少しにぎやかすぎました。
毎回、生い立ちから思い出していた
口の最初の版は、聞き取った言葉をふだん使っているClaude Codeのセッションに通知し、返事を書き終えたらフックで読み上げる作りにしていました。測ってみると、Claudeは呼ばれるたびに約7.5万トークンを読み直していました。話しかけられるたびに、生い立ちから思い出してから返事をしているようなものです。しかも返事を全部書き終えるまで読み始められないので、声が出るまで6〜8秒かかりました。
そこで、アプリが裏でclaude -pを起動したままにして、標準入力から発言を送る形に変えました。入出力はstream-jsonにして、–include-partial-messagesで返事を1文字ずつ受け取ります。
速さを左右したのは、起動時に読み込むものの量でした。プラグインやMCPや設定を全部読む通常の構成だと、最初の1文字まで2回目でも7.6秒、文脈は約4.7万トークンです。–strict-mcp-configと–setting-sources “”で読み込むものを絞ると、1.4〜1.5秒、約3千トークンになりました。道具を足しても0.9〜2.8秒に収まります。
口は達者でも、手は出させない
声のClaudeに渡している道具は、目(see・recall・watch)、Web検索、ファイルの読み取りだけです。読み取りも、アプリに登録したフォルダの中に限ってパス付きで許可しています。-pでは許可の確認に答えられないので、それ以外のフォルダは自動で断られます。
ファイルの変更とコマンドの実行は、道具ごと渡していません。マイクには同僚の声も入るので、誰かの一言でファイルが書き換わっては困ります。WebFetchも外しました。URLに読んだファイルの中身を載せれば、外へ送れてしまうからです。
会話はClaude Codeのセッション履歴に残しません(–no-session-persistence)。30分話しかけなければ、次は新しい会話になります。
しゃべりながら考える
返事は「。」「!」「?」と改行で文に区切り、1文できるたびにVOICEVOXへ渡します。書き終わりを待たず、しゃべりながら続きを考えてもらいます。合成は1文先まで先にやっておきます。最初の声を少しでも早く出したいので、最初の文だけは10文字以上たまったら読点でも区切ることにしました。コードブロックや表は読みません。
VOICEVOXは最初の合成だけ2.3秒かかるので、会話をONにした時点でエンジンを起動し、「はい」を1回言わせて温めておきます。本番前の発声練習です。
話し終わりから最初の声までの内訳は、無音の判定0.8秒、VADとWhisper1.0〜1.5秒、最初の文字まで0.9〜2.8秒、最初の文ができるまで0.2〜0.5秒、合成0.5〜1秒。合計でふつう4〜5秒です。
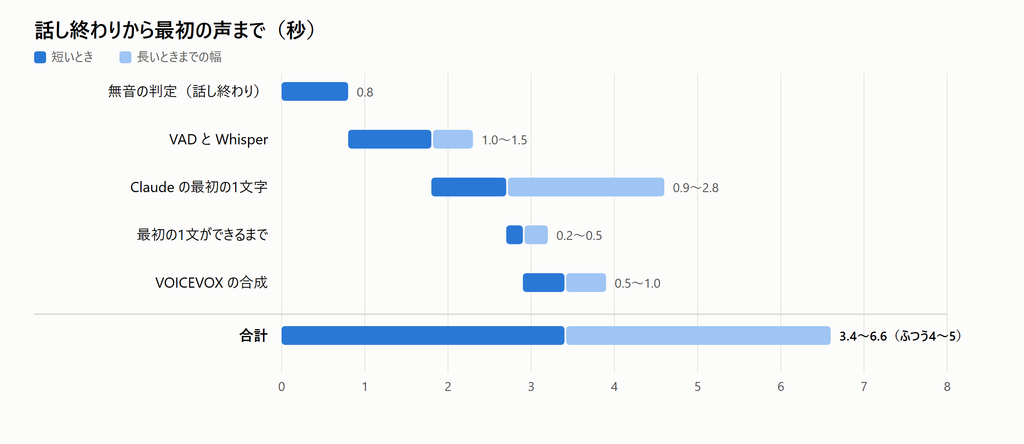
Web検索などで4秒たっても声が出ないときは、短い合図音を1回鳴らします。無言が続くと、考えているのか固まっているのか分からないからです。人間でいう「えーっと」の代わりです。
顔をつける
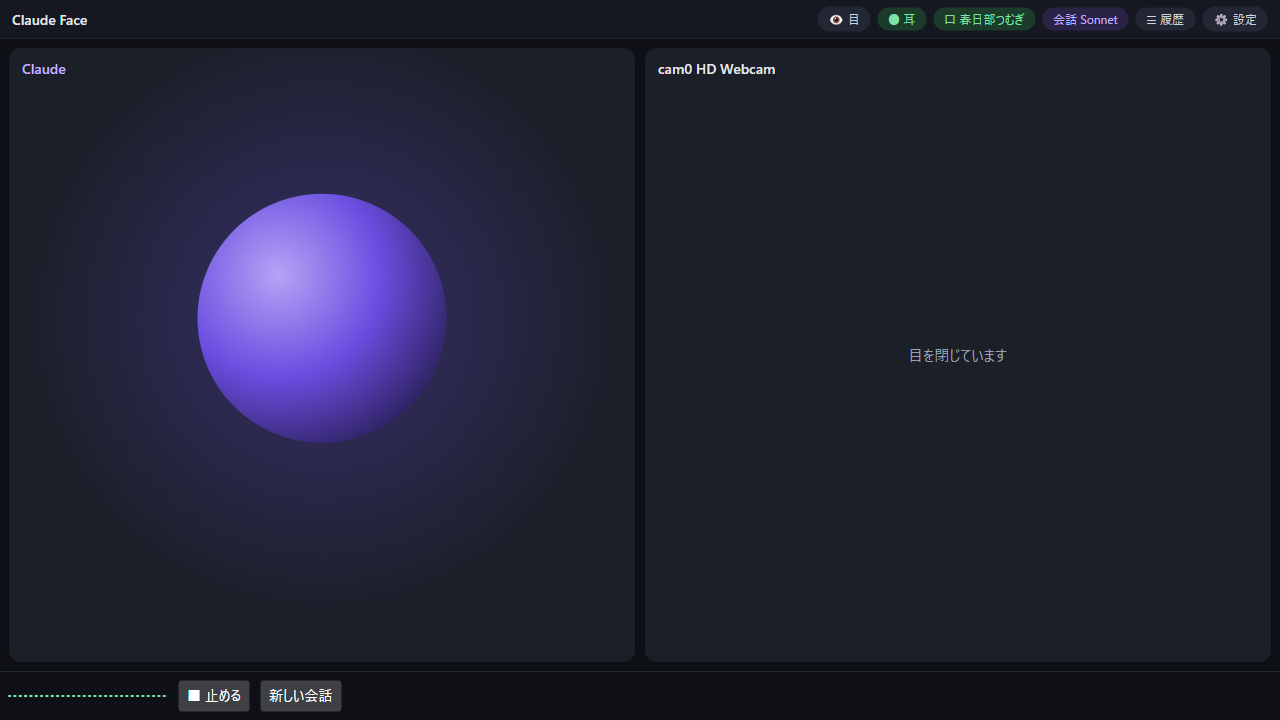
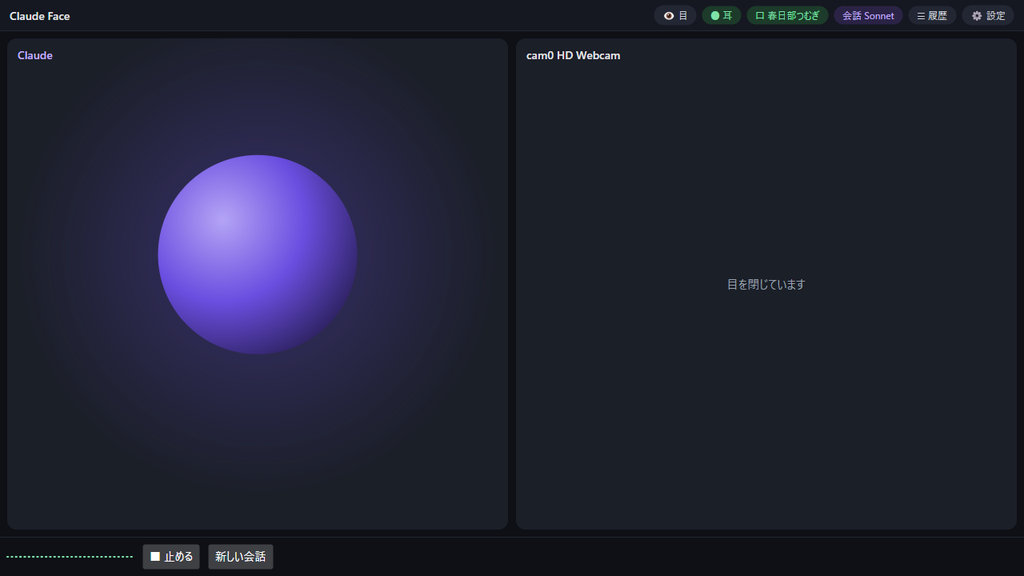
耳と口がついたころの画面は、WinFormsの標準部品を縦に積んだだけでした。どう見ても設定ツールで、話し相手の顔ではありません。ビデオ通話のような見た目にしたくて、Avaloniaで作り直しました。
左がClaude、右が自分のカメラ映像で、向かい合わせに並びます。Claudeの顔は、SkiaSharpで描いた光る球です。Claudeがしゃべる声や、こちらの声の大きさに合わせて球が動きます。言葉はそれぞれの映像の下に字幕で出ます。
目・耳・口・会話の状態は、上のバーのチップの色で分かるようにしました。設定と履歴は右からの引き出しにしまっています。
作り直したら、ウィンドウを閉じてもプロセスが残るようになりました。Avaloniaの後始末と終了処理が互いを待ってデッドロックしていて、帰ろうとしても帰れない状態でした。
使ってみて
返事の速さは、体感で「少し考えてから答える人」くらいです。ChatGPTの音声会話にはまだ届きませんが、話し相手としては十分しゃべってくれます。
作ってみて分かったのは、時間のほとんどがAIそのものではなく、その手前と後ろにかかったことです。物音を聞き流す、話し終わりを待つ、しゃべりながら考える、割り込まれたら黙る。人が無意識にやっていることを、1つずつ数字で決めていく作業でした。擬人化は、思っていたより地道です。
次は首を振れるようにしたいと思っています。
音声合成: VOICEVOX:春日部つむぎ